 AI Expense
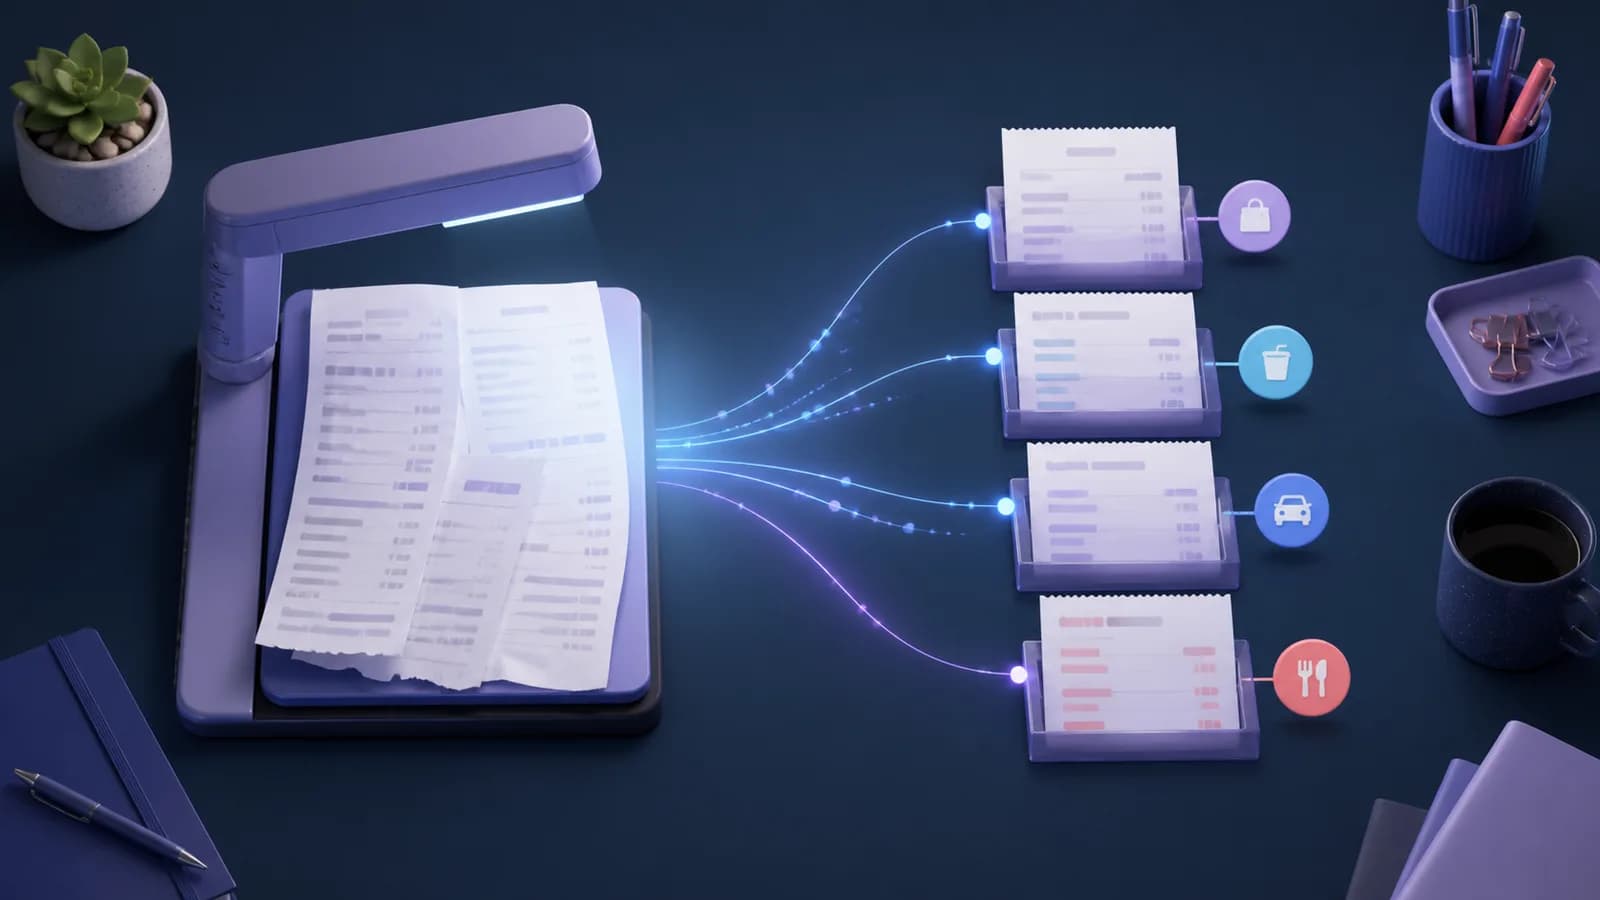
한 번의 스캔에 섞인 여러 영수증 분리하기
한 번의 스캔에 섞인 여러 영수증 분리하기. AI Expense로 지출 문서를 가져오고 검토하고 검색하고 내보내는 실용적인 흐름입니다.
AI Expense 편집팀 게시 · EmuInbox
한 번의 스캔에 섞인 여러 영수증 분리하기
한 번의 스캔에 섞인 여러 영수증 분리하기에서 중요한 것은 표를 깔끔하게 만드는 일만이 아닙니다. 각 금액이 읽을 수 있는 영수증, 계산서, 이메일 첨부 또는 PDF와 계속 연결되어야 합니다. 원본을 찾을 수 없는 정리된 표는 나중에 다시 확인하기 어렵습니다.
실제 문제는 입력이 아니라 증빙 관리
AI 인식은 첫 단계입니다. 중요한 항목을 원본과 대조하고 불확실한 기록을 대기 상태로 남겨야 신뢰할 수 있습니다.
이 상황에서 따로 결정할 사항
한 번의 스캔에 섞인 여러 영수증 분리하기에서는 가장 신뢰할 수 있는 원본을 먼저 정합니다. 전체 PDF가 잘린 사진보다 나을 수 있고, 읽을 수 있는 종이 영수증이 이메일 제목에 없는 내용을 보여 줄 수도 있습니다. 인식 값을 수정하기 전에 대조 기준을 선택합니다.
첫 작업은 혼합 문서를 개별 기록으로 분리하기입니다. 구매 상황을 기억할 때 처리하고 다음 확인 단계에서 품목별 내역 검토하기를 수행합니다. 두 자료가 다르면 결과를 억지로 확정하지 말고 모두 유지한 채 검토 대기로 남깁니다.
세 번째 작업인 인식된 항목을 원본과 대조하기가 이 기록의 완료 기준입니다. “한 번의 스캔에 섞인 여러 영수증 분리하기”의 실제 질문에 답할 수 있어야 하며 화면을 정돈하는 데서 끝나면 안 됩니다. 다른 담당자도 기억에 의존하지 않고 판단할 수 있어야 합니다.
“한 번의 스캔에 섞인 여러 영수증 분리하기”을 인계 질문으로 사용해 혼합 문서를 개별 기록으로 분리하기에서 품목별 내역 검토하기로 이어진 이유와 인식된 항목을 원본과 대조하기를 가능하게 한 근거를 기록합니다. 이 메모가 일반 영수증 점검표와 해당 사례를 구분합니다.
원본 중심의 흐름 만들기
- 혼합 문서를 개별 기록으로 분리하기.
- 품목별 내역 검토하기.
- 인식된 항목을 원본과 대조하기.
- 원본 파일 유지하기.
- 검토 전과 검토 완료 기록 구분하기.
한국에서 접할 수 있는 실제 예시
“한 번의 스캔에 섞인 여러 영수증 분리하기” 상황을 생각해 보겠습니다. 사진, PDF, 이메일에 나뉜 문서를 하나의 대기열로 모으고 날짜와 통화(KRW)를 확인한 다음 검토가 끝난 기록만 다음 단계로 보냅니다.
기록을 사용하기 전 확인할 항목
거래처, 날짜, 합계, 표시된 세액, 통화와 필요한 품목을 확인합니다. 잘렸거나 흐리거나 모호한 값은 원본으로 돌아가거나 대기 상태로 둡니다. 빈 금액을 추정해 채우지 않습니다.